こんにちは。認証チームの今廣(いまひろ)です。
1 年ほど前、Claude CodeでJiraのチケット駆動開発を強固に加速させる! という記事で、Jira のチケットを起点に Claude Code を開発フローへ組み込んだ話を書きました。当時書いたのは、チケットの作業のうち実際に成果物を生成する工程を、カスタムコマンド(いまはスキルとして整理し直しています)で AI に置き換えた話でした。テストケースを記述する工程と実装する工程を AI が担い、それ以外は人間が主導して協業する形態です。
それから 1 年、認証チームの「Jira のチケット駆動開発」のフローは大きく変わりました。変化のきっかけになったのは、グラフエンジニアリングという考え方です。
今回は、専用のワークフローエンジンを使わず、Jira の標準機能と Claude Code のスキルを土台に組み立てた開発フローについて書きたいと思います。AI エージェント自身が、Jira のチケットに対してサブタスクと課題リンクでグラフを設計・構築し、そのグラフをたどって自走でチケットを消化していく仕組みについてです。
グラフエンジニアリングとは
AI エージェントを組み合わせたシステムを、ノード・エッジ・ステートからなるグラフとして明示的に設計するやり方は、グラフエンジニアリングと呼ばれています。1 つのエージェントに延々とループを回させて成り行きに任せるのではなく、どのノードからどのノードへ遷移してよいかをあらかじめ決めておくのが要点です。LangGraph などが以前から実装してきた考え方にあたります。
| 要素 | 意味 |
|---|---|
| ノード | 1 つの作業単位。実装・テスト・レビュー・リリース確認など |
| エッジ | ノード間で許される遷移。実行順序・並列・条件分岐、そして差し戻したときの戻り先 |
| ステート | ノードをまたいで持ち回る状態 |
関連して、Anthropic は、あらかじめ決められた経路で LLM とツールを組み合わせるものを ワークフロー(workflow)、LLM 自身が進め方とツールの使い方を動的に決めるものを エージェント(agent) と呼び分けています(Building effective agents)。この区分でいえば、私たちのフローは 2 段構えになっていて、グラフを組み立てる工程はエージェント寄り(どのノードを置くかは AI が決めます)、組み上がったグラフをたどって実行する工程はワークフロー寄りです。
同記事が挙げるパターンでいうと、後述するコード・セキュリティ・QA の 3 並列レビューは parallelization、レビューでの差し戻しは evaluator-optimizer(生成する側と評価する側を分けて反復する構成)に対応します。工程の途中に検査を挟むこと自体は、同記事が prompt chaining の図で gate と呼んでいる考え方と同じです。ただし同記事の gate はコードによる機械的なチェックを指しているのに対し、私たちが置いているのは AI のレビュアーです。
なぜ専用のエンジンではなく Jira なのか
ワークフローをグラフとして設計すると決めたとき、素直な選択肢はワークフローエンジンを導入することだと思います。ですが認証チームでは、すでに活用している Jira をそのままグラフの実体として定義することにしました。
| グラフの要素 | Jira 上の実体 |
|---|---|
| ノード | サブタスク |
| エッジ | 課題リンク(Blocks) |
| ステート | サブタスクのステータス、チケットのコメント、PR |
理由は 3 つあります。
1. ステートの置き場として求められる条件を、最初から満たしている。 私たちの使い方では、グラフのステートは「会話の記憶の外にあり、永続し、複数のセッションから同じものが読める」必要がありました。エージェントのセッションは終われば消えるため、別のマシンや翌日のセッションから再開するには、どこかに残す仕組みが別途要ります。Jira のステータスとコメントは、この条件をそのまま満たしていました。
2. グラフの実行状況が、標準で可視化される。 これが最大の利点でした。専用のエンジンを立てると、進行状況を見るための画面をこちらで用意しなければなりません。Jira であれば、特に新しいことを何もしなくても今どのノードで詰まっているかがボード上で明らかになります。 開発メンバーに限らず、チームの外から進み具合を見る人も、いつも見ている Jira の画面で状況を知ることができます。
3. チームが覚え直すことがない。 グラフエンジニアリング自体はチームにとって新しい考え方ですが、日々触るツールは Jira のままです。新しい画面の使い方を覚えてもらう必要はなく、グラフを作成・実行するスキルを組み込むだけで実践に移せました。エージェント専用のストアを別に立てていたら、ここに「そのツールの使い方」と「Jira への同期」という 2 つの負担が乗っていたはずです。
グラフエンジニアリングというと専用のフレームワークの話のように聞こえますが、要は「ノード・エッジ・ステートを何に持たせるか」を定義する作業です。それを新しいツールを導入して行う必要は必ずしもなく、チーム開発の基盤として運用されている Jira 上で行ったことで、可視化が最初から備わった状態になりました。
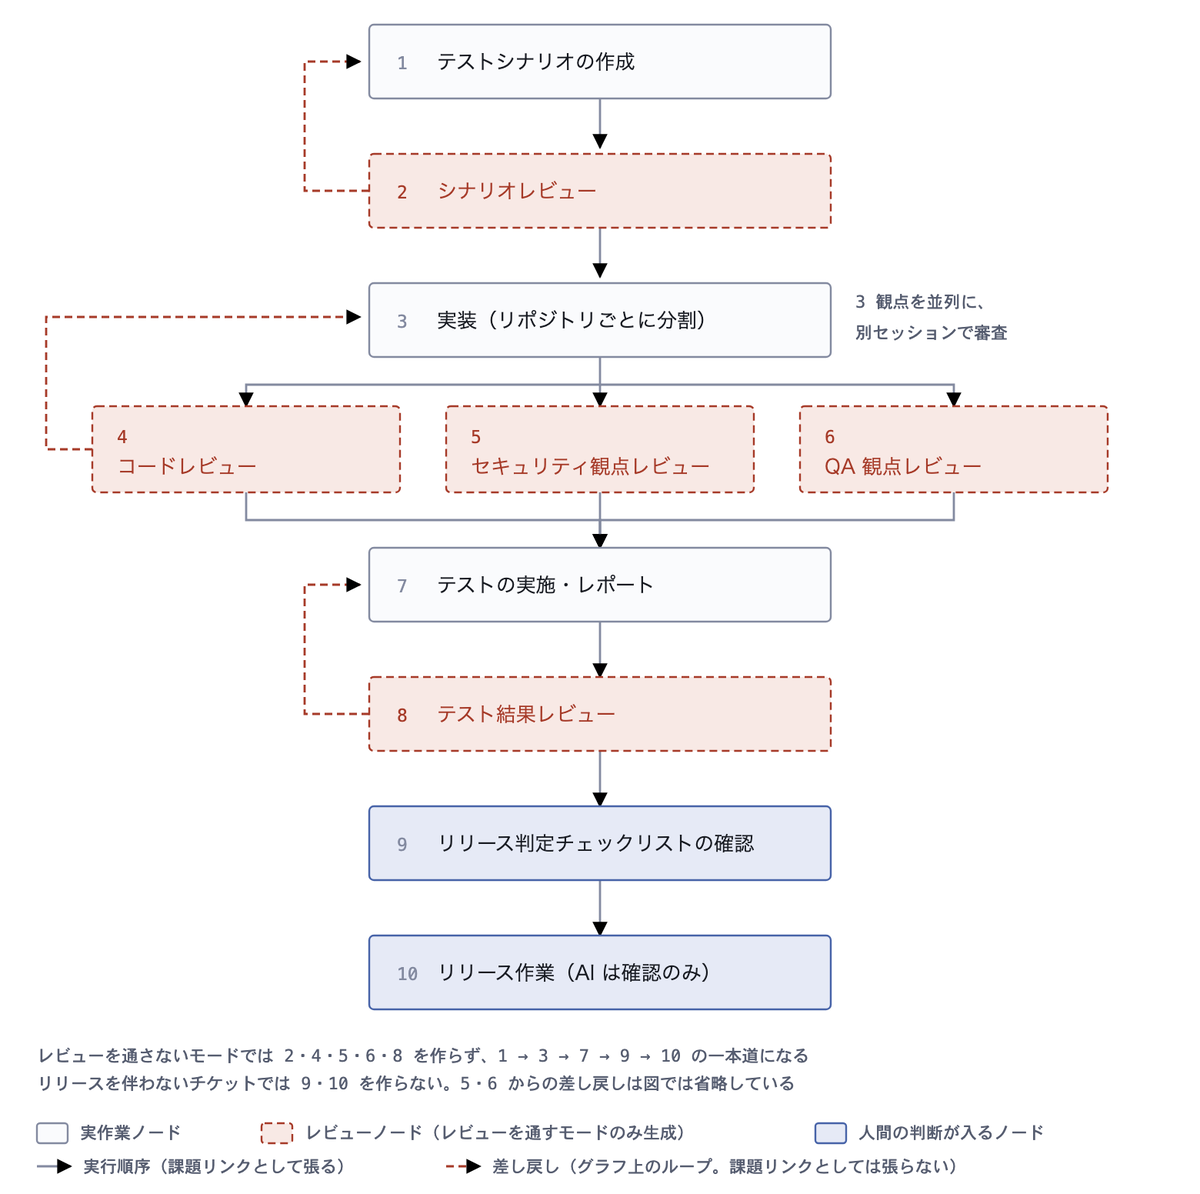
実際に生成されるグラフは、以下のようなフローになります。
差し戻しのループを、エッジとして張らない工夫
このグラフはループを含んでいます。レビューで差し戻されれば前のノードへ戻り、同じノードを何度も通ります。図でいえば破線の部分です。
ただ、この差し戻しを Jira の課題リンクとして張ると、着手できるノードの判定が成り立たなくなります。 依存関係がループすると「次に着手できるノード」を機械的に決められないからです。A が B をブロックし、B が A をブロックしている状態では、どちらも着手できません。
そのため、Jira の課題リンクとして張るエッジは順方向だけにして、差し戻しは「レビューノードを未完了のまま残す」形で表現しています。 どこまで戻ってやり直すかは、課題リンクではなくレビュアーの判定結果とスキルの手順の側に持たせました。グラフの上ではループがありますが、Jira 上の依存関係としては一方向、という二層構造です。
全体像 — 4 つの工程
認証チームの開発フローは大きく 4 つの工程に分かれています。
| # | 工程 | やること |
|---|---|---|
| 01 | 入口 | 着手前にチケットを「検証できる完了条件」まで精緻化する |
| 02 | 構成 | 必要なノードだけを選んで起票し、エッジでつなぐ |
| 03 | ゲート | 各種レビュアー用のエージェントが観点ごとに審査する |
| 04 | 出口 | 成果物を人間が読み切れる形にして配布する |
各工程にそれぞれ設計の意図がありますが、「入口の精度が低ければ、後工程のレビューをどれだけ手厚くしても取り返せない」というのが設計思想の根本にあります。
01. 入口 — アウトプットの品質はインプットで決まる
AI に渡すチケットの粗さは、後工程すべてに拡大して影響します。ノードを 10 個に割ってから「そもそも完了条件が曖昧だった」と気づくと、10 個分やり直しになります。
そこで入口に、リファインメント専用のスキル(/refine-ticket)を置いています。やることは、Jira のチケットの精度を高め、人間と AI の認識の齟齬を限りなくゼロに近づけることです。具体的には、あらかじめ起票されたチケットの説明文を読み、標準テンプレート(完了条件 / WHY / 開始条件 / メモ)に照らして「記載済み・一部記載・未記載」に分類したうえで、6 つの観点を一問一答形式で人間と合意し、再度チケットの説明文に反映していく作業を行います。
| # | 観点 | 確認すること |
|---|---|---|
| 1 | 完了条件 | 検証できる粒度になっているか。曖昧な表現や複数条件の混在がないか |
| 2 | WHY / 背景 | 依頼元、見送った代替案、「なぜ今なのか」 |
| 3 | 開始条件 | 依存チケット・環境・データ・権限が揃っているか |
| 4 | 対象範囲 | 対象リポジトリ、含める / 含めない機能、影響範囲 |
| 5 | 実装上の判断 | 既存実装を流用するか新規に作るか、命名と粒度 |
| 6 | テスト方針 | シナリオ / ユニット / 実機検証の要否 |
すでに書かれている観点は「この内容で合っているか」という AI 側の理解の確認だけに短縮し、未記載の観点を丁寧に掘り下げます。全部を毎回丁寧に聞くと人間が疲れて、答えが雑になるからです。
質問を作る前に、AI 側が事実ベースで前提を固める
一問一答というと「AI が疑問点を並べて人間が答える」形を想像されると思いますが、それだと質問が推測だらけになり、人間は Yes / No しか答えられません。
そこで、質問を作る前に、知識ベース・進行中の作業記録・実際のコードを確認して、チケットに書かれていない前提を先に固めさせています。リモートブランチを取得してから見る、「問題がある」と書かれた箇所については同じ形の実装をすべて洗い出す、ドキュメントの記述を「実装が存在する証拠」として扱わない——といった手順まで決めてあります。
事実を先に固めると、質問が 「Yes / No」から「A 方式か B 方式か」に変わります。 実際、処理順序と呼び出し箇所を先に全部確定させたことで、6 観点すべてを方式の選択として合意でき、あわせて「対象外なのに作業範囲に入りかけていた 3 箇所」も除外できた、という実例もありました。
前提と根拠の表明を義務とする
リファインメントに限らず共通のルールとして、各ステップの着手前に「前提としていること」と「その根拠」を 1 行で出力させています。 根拠の出どころは [チケット] [実行計画] [知識ベース] [コード] [推測] のタグで示します。
🧭 Step 8: 実装
前提: 入力値は正規化済みで保存される想定 [実行計画]/既存のバリデータを再利用できる [コード]/
      エラー時の画面文言はチケットに記載がないため既存画面に合わせる [推測]
理由: 実行計画の変更対象ファイルに従い、重複調査を避けて実装を進めるため
最も重要なのは [推測] です。 どこにも書かれておらず、AI が推測で補った前提であり、認識のずれが最も起きやすい箇所だからです。人間は AI の推測については重点的に確認することになります。
前提の表明を義務にしたのは、そのノードが何を前提に動いたかを、その場で人間に見えるようにするためでもあります。グラフを回すうえで、あとから「なぜこの判断になったのか」をたどれることが必要だからです。
02. 構成 — グラフの形はチケットごとに変わる
固定のテンプレートを全チケットに当てはめるのではなく、計画立案のスキル(/plan-ticket)が実行計画を立てながら、「モード」「実行環境」「リリースの有無」「変更内容」 等の観点をもとに必要なノードを自分で選び、ノードとなるサブタスクを Jira のチケット内に起票し、エッジにあたる課題リンクでつないでグラフを構成していきます。
2 つの軸 — モードと実行環境は独立させる
当初はフローの「手厚さ」を実行環境で決めるよう設計していました。人が見ている場では軽く、裏で動かすときは手厚く、といった具合です。
ですがこれは 2 つの別の話を 1 つの軸に押し込んでいて、「裏で動かすが軽く済ませたい」「目の前で動かすが丁寧に見てほしい」が表現できません。 そこで軸を 2 つに分けることにしました。
| 軸 | 決めること |
|---|---|
| モード(full / lite) | レビューゲートを通すかどうか、そのためのノードを作るかどうか |
| 実行環境(対話 / 非対話) | 成果物の出し方(通知の要否・レポートの出力先・人間への質問の可否) |
組み合わせは 4 通りになります。
| 対話セッション | 非対話セッション(自動実行) | |
|---|---|---|
| full | 質重視の個人タスク。全ゲート発動 / 通知なし / 質問可 | 自動実行(既定)。全ゲート発動 / 通知あり / 質問不可 |
| lite | モブ・速度優先(既定)。ゲートなし / 通知なし / 質問可 | 例外運用。ゲートが 1 つも発動しない点に注意 / 通知あり / 質問不可 |
モードはセッション単位で決まり、チケット側には固定しません。日中のモブで lite として進めたチケットを、自動実行が full で引き継ぐような運用も可能です。このとき、レビューノードを後から追加して、すでに完了した実作業ノードもさかのぼってレビューするようにしています。
どのノードを作るかは、AI に判断させる
冒頭で「AI エージェント自身がグラフを設計・構築する」と書いたのは、具体的にはこの部分です。テンプレートから機械的に展開しているのではなく、チケットの内容を読んで、そのチケットに要るノードだけを AI が選びます。
- テストシナリオのノードを作るか: ブラウザ操作で確認できる画面の流れを持たない(バリデータ・値オブジェクト等)、インフラの設定値のみの変更、ドキュメントだけの変更——この 3 つに当たる場合は作りませんが、迷ったら作る方を選ぶ、と決めています
- リリース関連のノードを作るか: 「PR のマージ後に、本番へ反映する工程が別途あるか」で判断します
- 条件付きノードを足すか: 事前調査から派生作業を見つけて追加します。ドキュメント更新はリリース後に、画面文言の変更に伴う翻訳対応は実装後・テスト前に——といったグラフ上の挿入位置まで AI が決めます
ここで効いているのが、追加しなかった場合も理由を記録させるという決めごとです。「兆候なし」と明記させることで、人間が後から判断の妥当性を確認できます。何も書かれていないと「検討したのか、忘れたのか」が区別できません。
ノードを進める順序の決め方
/step-subtask は 1 回の呼び出しで 1 ノードだけを消化して終わります。対象は番号順ではなく、エッジを辿って着手できるかどうかで選びます。
| ノード種別 | 着手できる条件 | 作業を終えた時点の状態 |
|---|---|---|
| 実作業ノード | 前工程がすべて完了(または対応しない) | いったん「レビュー中」(full)/そのまま完了(lite) |
| レビューノード | 前工程が「レビュー中」以降になった(完了を待たない) | APPROVE ならこのノードが完了/REVISE ならこのノードは未完了のまま |
レビューノードだけが着手条件の例外になっています。 full の実作業ノードは、対応するレビューノードがすべて APPROVE になって初めて「完了」へ進みます。そのためレビューノードの着手条件を「前工程が完了」にすると、実作業ノードはレビューの APPROVE を待ち、レビューノードは実作業ノードの完了を待つという、互いが相手を待つ状態になってしまいます。
これは、先に触れた「差し戻しをエッジとして張らない」話とは別の詰まり方です。あちらは課題リンクの向きがループする問題、こちらはステータスの待ち条件が一巡してしまう問題で、対処もそれぞれ別に必要でした。
もう 1 つ、進捗を会話の記憶で数えないというのが重要なルールになっています。1 ノードを消化するたびに、全ノードのステータスを Jira から取り直します。対話セッションと自動実行セッションが同じチケットを並行して進めることがあるため、記憶を信じると同じ作業を二重にやってしまうからです。
そして毎回、「進行中」のまま残っているノードに最優先で着手します。 これは前のセッションが着手して終えられなかった痕跡です。放置すると、そのノードは着手済みなので「次に着手するノード」の候補には挙がらず、かといって完了もしていないので後続のノードも動き出せません。結果として、グラフが終わっていないのに「進められるノードがありません」という理由で止まり続けるという状態になります。再開時の進捗も、会話の記憶ではなくコメントや PR といった証跡から復元させています。
03. ゲート — レビューをノードとして持つ
ここはグラフ化の恩恵が大きかった部分です。レビューを、作業の中の一手順ではなく、Jira 上に実在するサブタスクとして置いています。 誰が何をどこまで見たかが、そのまま Jira 上に表現されています。
ゲートは 6 つあります。
| ゲート | 審査対象 | 記録先 |
|---|---|---|
| plan-review | 実行計画とシナリオ案(実装前) | Jira |
| gherkin-review | 実施前のテストシナリオ | Jira |
| code-review | 実装の差分(正しさ・規約準拠・不要物の整理) | PR |
| security-review | 実装の差分(認証・認可・秘匿値) | PR |
| qa-review | 実装の差分(仕様との整合・異常系) | PR |
| test-result-review | 実施後のレポートが信用できるか | Jira |
注目していただきたいのは、実装だけでなく「計画」「テストシナリオ」「テスト結果レポート」にもゲートがあることです。特に最後の 1 つ、テストを実施した本人が書いたレポートを、別のレビュアーが「これは信用できるか」の観点で審査するというのは、入れてみて効果の大きかった仕掛けでした。以前のスクリーンショットが再利用されていたり、実施していないシナリオが「確認済み」として並んでいたりといった不整合は、書いた本人の自己申告では出てこないからです。
3 つの観点を、並列のノードとして持つ
実装の差分に対するレビューは、コード・セキュリティ・QA の 3 つに分けて並列で走らせます。 図1 でいえば、実装ノードから 3 本に分岐している部分です。
分けた理由は、1 つのレビュアーに「コードもセキュリティも QA も見て」と頼むと、探索の深さが観点ごとに偏るからです。実際、全観点をまとめて 1 回で見せた場合と、セキュリティだけに絞って見せた場合で、同じ差分に対する結果が変わりました。
ただし、レビュアーの定義は 3 つに複製していません。 定義は 1 つのままで、「今回はこの観点だけを深く見る」という指定と、その観点の項目一覧だけを渡し分けています。事実確認の手順や判定の書式といった共通部分を複製すると、見直しが全部に行き渡らなくなるからです。
観点の定義も 1 箇所に集約しています。 「何を見るか」はレビュアーの定義にもスキルの定義にも書かず、観点ファイル群だけを基準にしています。同じ差分をレビューする経路が複数あるので、観点を複数箇所に置くとどこから実行したかによって見落とすものが変わってしまいます。
そして観点ファイルの内容は、人間のレビューで「AI が見逃していた観点」が見つかったら 1 行足すという運用で育てています。AI 側を賢くしようとするのではなく、渡す観点を育てる、という考え方です。
観点が渡されなかったら、審査せずに止める
レビュアーの判定は、決まった書式で返させています。
VERDICT: APPROVE | REVISE | BLOCKED
(何回目の判定か / 前回指摘のうち未解消の番号 / どの観点を適用したか)

## 確認した観点
- 通した根拠を 1 行ずつ

## 指摘(差し戻す場合、番号付きで全件)
1. 観点 / 対象箇所 / 何が問題か / 事実確認の結果 / 修正の方向
3 つめの BLOCKED が効いています。これは「審査に必要な入力(観点の定義や差分)が届いていない」という意思表示で、記憶や一般論で代わりに審査することを禁じています。
賢い LLM はこちらの意図を汲んで、気を利かせて「それらしい」判定を返してくることがあります。しかしこれでは、呼び出し側は「きちんと観点に沿って審査された」と信じ込んでしまいます。だからこそ、「自分が確認できていないものは絶対に合格にしない」という厳格な方針を、システムプロンプトの指示だけでなく、出力の「型」として強制的に持たせることにしました。
裏付けのない指摘では差し戻さない
指摘は「発見」→「検証」の 2 段階を通し、検証に耐えたものだけを差し戻しの根拠にします。
| 判定 | 意味 | 扱い |
|---|---|---|
| CONFIRMED | 問題を起こす入力や状態を具体的に示せ、該当行を引用できる | 差し戻せる |
| PLAUSIBLE | 仕組みとしては起こりうるが、発生条件を特定できない | 単独では差し戻さず「参考指摘」として分けて記載 |
| REFUTED | 事実誤認、または別の箇所ですでに防がれている | 取り下げる |
「セキュリティに関する指摘だから自動的に最高深刻度」とはしません。攻撃が成立する条件を具体的に示せて初めて最高深刻度になります。 どう失敗するかを書けない指摘は載せません。裏付けのない差し戻しは、次に述べるループの空回りに直結するからです。
ループは、必ず収束するように設計する
さて、運用してみていちばん学びが大きかったのはここです。
レビューを手厚くすると、今度は終わらなくなります。
実際に起きたことを 1 つ挙げると、テンプレートを 1 行変更するだけのチケットで、計画レビューが 3 回・シナリオレビューが 6 回差し戻され、レビューだけで 2 セッション・約 4 時間を費やしたことがありました。当時は繰り返しの上限を置いていなかったので、6 回差し戻されても自動では止まりませんでした。指摘の質そのものは高かったのですが、毎回新しい観点が出てくるので終了条件が成立しないのです。
前述のとおり、このグラフはループを含みます。そして「いつか必ず終わること」は、グラフの形からは保証されません。 人間のレビュアーなら「3 回目だし、これは次で拾おう」と自然に判断しますが、エージェントはしません。指示していないのだから当然です。
そこで、繰り返すたびに、新規指摘を認める範囲を深刻度で段階的に狭めるようにしました。
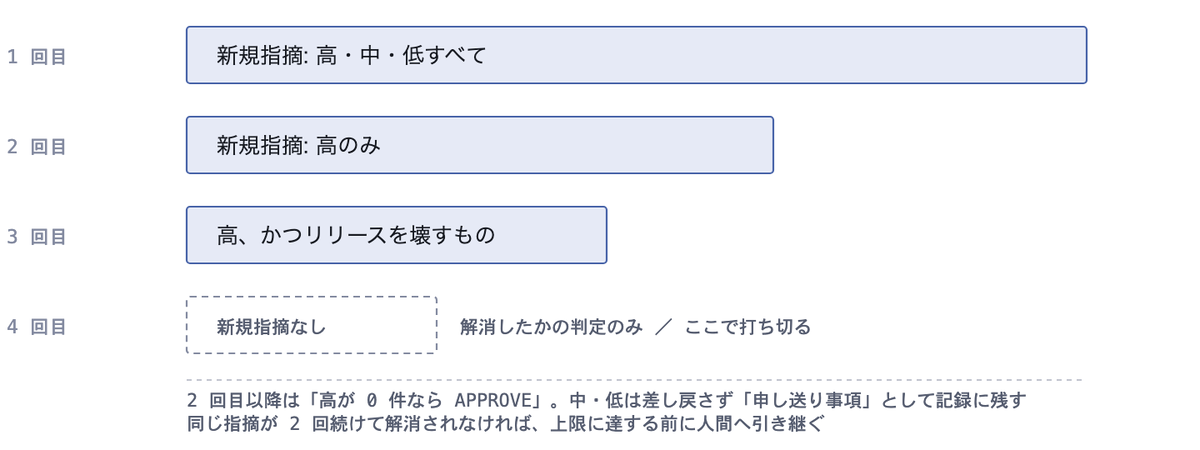
| 何回目か | 前回指摘の解消判定 | 新しく指摘してよい範囲 |
|---|---|---|
| 1 回目 | — | すべての深刻度 |
| 2 回目 | 必ず最初に行う | 深刻度が高いものだけ |
| 3 回目 | 必ず最初に行う | 高かつ「直さずに出すと壊れる / 脆弱性が残る」ものだけ |
| 4 回目 | 必ず最初に行う | 禁止(前回指摘が解消されたかだけを見る) |
あわせて停止条件を 2 つ置いています。
- 同じ指摘番号が 2 回続けて解消されなかったら「進んでいない」と判断して打ち切る
- 4 回目を上限として打ち切る
どちらの場合も、そのノードは未完了のまま人間に引き継ぎます。ただし、他に着手できるノードがあれば進めます。 1 ノードの詰まりでグラフ全体を止めないのも、ノードに分割した恩恵です。
この設計にはコスト面の理由もあります。 レビュアーを 1 体動かすと、実測で 約 9 万〜19 万トークンを消費しました(入力の規模で変わり、実際のチケットでは上振れることもあります)。チケット 1 枚で複数のゲートを何度も回せば、それだけで利用上限に達します。 「完璧になるまで通さない」は、動かない設計でした。いまは 1 件の変更に対して、ゲートをまたいだ差し戻しが通算 5 回以上になったら、レビューの設計自体に問題がある兆候として扱っています。
なお、この回数も会話の記憶では数えません。 判定は要約や言い換えをせず、そのまま Jira / PR のコメントへ記録します。そして次の判定のときは、直近のコメントに書かれた「何回目か」の行を読み直して数えます。 記録がそのまま回数の数え役を兼ねる形です。会話の中だけの承認は、無かったものとして扱います。
04. 出口 — AI の処理速度と人間の認知限界のギャップを埋める
グラフを回せるようになると、次に直面するのは「人間の処理能力の限界」です。AI が提出する成果物の量は、人間が読んで理解できる速度をたやすく超えてしまい、結果として確認待ちの列ができてしまうからです。
そこで調査レポート・テストレポート・レビュー結果・自動実行レポートは、スクリーンショットまで埋め込んだ 1 ファイルで完結する HTML として生成し、チームのポータルへ自動で公開します。この仕組み自体は以前 Claude Codeのアウトプットを人間がインプットしやすい形へ — Artifact品質のHTMLドキュメントをGoogle Driveに集約する で紹介したものです。

通知の形は 2 つ用意しています。公開に成功したときは 12 行程度の要約(状態・稼働時間・完了したノード数・PR・止まっている原因・次に人間がやること)と共有 URL だけを流します。公開に失敗したときだけ、詳細レポート全文の投稿に切り替えます。 もともとは全文投稿だけだったのですが、長すぎて読み通せませんでした。かといって要約だけにすると、公開に失敗したときに詳細を読む手段が消えてしまうので、こういう形に落ち着いています。
レビューがすべて終わった PR については、人間に渡す前に整える工程を入れています。PR の説明文を最終的な成果の形に書き直し、AI が投稿したコメントは解決済みにして折りたたみます。人間のコメントは開いたまま残します。
AI のレビュー指摘と修正が何度も繰り返されると、PR のコメント欄は膨大な情報で埋まり、人間が読み通せる範囲を超えてしまいます。 そこで、AI 同士のやりとりについては AI 内部での対話とみなし、最終的な結論だけを PR へまとめさせるようにしました。内部で閉じるとはいえ、PR のやり取りで得た知見は AI が参照する知識ベースへ蓄積されていくので、レビューを繰り返すたびに成果物の質が上がるだけでなく、次のレビューで AI に渡せる材料そのものが増えていく仕組みになっています。
外に出る成果物では、シークレットに限らず「公開されておらず、漏れると防御を迂回できてしまう値」全般を伏せ字にしてから出すようにしています。値そのものはプレースホルダに置き換え、仕組み・場所・影響・対策は具体的に残す——「どこに穴があるか」は伝えつつ「実際に突破できる値」は渡さない、という方針です。
同じグラフを、非対話セッションで回す
ここまで見てきた 4 つの工程は、そのまま非対話セッションで自動実行させることも可能です。

大事なのは、自動実行のために別のフローを作っていないという点です。変えたのは 2 つだけで、モードの既定値(対話は lite、非対話は full)と、成果物の出し方(通知とレポート公開が増える)です。非対話では人間へ質問できないぶん、既定が full になることで、人間の確認をレビューゲートが肩代わりする形になります。グラフそのものは対話セッションと同一です。前述の「モードと実行環境を独立させた」設計が、ここで効いています。
起動前の事前チェックは、LLM の自己申告ではなくシェル側でやっています。 認証が切れていると何もできずに終わるのですが、「認証を確認してから始めてください」とプロンプトに書くだけでは確実に効きません。 そこで起動スクリプト側で機械的に確認し、通らなければ待ち行列を消費せずに終了します。何も処理されていないのにチケットだけ待ち行列から消えている、という事態は起きません。
もう 1 つ対処が必要だったのが、「毎回同じチケットを選んでしまう」問題です。Jira から対象を選ぶ経路では、一度実行しても、そのチケットは候補から消えません。 そのため、人間の対応待ちで止まっているチケットが毎回選び直されます。実際に、クラウドの認証情報の失効と依頼者への確認待ちで塞がれたチケットが 3 回続けて選ばれ、3 回目は 9 分で「本題はまったく前に進んでいない」と報告して終わることがありました。
対処として、ステータスとは別の軸に「自動実行では進められない」を表すラベルを設けました。判断するのはセッション自身で、「このまま再投入しても前に進まない」と申告させます。その申告を起動スクリプト側が読み取って、実際にラベルを付ける——という分担です。そしてこのラベルを外すのは人間だけにしています。付けるのは AI、外すのは人間。塞いでいた原因が解消したかを判断できるのは人間だけだからです。
人間が握り続けるもの
自動化した範囲と同じくらい、「自動化しないと決めた範囲」がこのフローの特性を表しています。
| 判断 | 誰が | 理由 |
|---|---|---|
| PR のマージ・本番リリース | 人間のみ | AI は「マージ済みか」「本番へ反映済みか」を確認するだけ。自動実行が作る PR は必ず draft |
| リリース可否の判定 | 人間のみ | 該当ノードは「判定するノード」ではなく判断材料を揃えるノード。全項目を ✅充足 / ⚠️不足 / 🧑人間 / ➖対象外 に仕分け、根拠を添えて一覧にするところまでが役割 |
| リリース判定の承認者 | 人間のみ | AI は自分を承認者にしない。常に「🧑 人間」として残す |
| リリースを伴わないチケットの「完了」 | 人間のみ | 「完了」は Done カテゴリでボードから消えるため、人間が成果物を見る前に確認の機会が失われる。AI は「レビュー中」で止めて報告する |
| 共有ブランチへの書き込み | 人間の承認 | 遅れているコミット数と変更ファイル数を提示して承認を取る |
グラフ自体を改善し続ける
このワークフローは一度決めて終わりではなく、運用で見つかった抜け漏れを反映先ごとに振り分けて更新し続けています。
| 観測したこと | 反映先 |
|---|---|
| 再利用できる調査結果・手順・つまずきやすい点 | 知識ベース |
| 特定の作業の進め方の改善点 | 該当スキルの定義 |
| プロジェクト横断で守るべき制約 | 共通ルール |
| AI レビュアーの見逃し(人間レビューで発覚) | 観点ファイルへ 1 行追記 |
| AI レビュアーの判定手順の不備 | レビュアーの定義 |
| 機械的に判定できる同じ種類の指摘の繰り返し | CI・静的解析へ移す(AI に毎回判定させない) |
最後の行が個人的には重要だと思っています。同じ指摘が繰り返されるなら、それは AI に毎回判定させる話ではなく、機械的なチェックへ移す話です。ゲートは万能ではなく、置き場所を間違えると毎回コストを払うことになるからです。
追記するときは、必ず背景を 1 行添えるようにしています。「PR ○○ で人間が指摘、AI レビュアーは見逃していた」といった具合です。由来が分かると、後から「これはもう不要」と判断できます。実際、ルールのほとんどは、失敗を振り返って 1 行ずつ足してきたものであり、抽象的な理想から導いたものではありません。
まとめ
1 年前、Jira のチケット駆動開発における AI の役割は「テストを書く」「実装する」の 2 つだけでした。現在は「チケットをノードとエッジのグラフに展開し、依存が満たされたノードから 1 つずつ消化し、その途中に置かれた独立したレビュアーのゲートまで担う」というところまで広がっています。
冒頭にも書いたとおり、グラフエンジニアリングそのものは新しい概念ではありません。動的にグラフを組む手法も、課題管理をグラフとして扱う手法も、すでに世の中にあります。ですがその 2 つを重ねて、「AI がその場で組んだグラフを、チームが毎日見ているボードにそのまま書き出す」ところまでやっている例は、調べた範囲では見当たりませんでした。
やってみると、この重ね方は思っていた以上に良い方向に働きました。AI が次のノードを選ぶために読む依存関係と、人間が進み具合を見るボードが同じものなので、片方のために整えたことが、もう片方にもそのまま効きます。 ステートの永続と可視化が Jira の側にもとから備わっていることも大きいと思います。
実践して得た勘所を並べておきます。
- グラフは、チームがすでに見ている場所へ書き出す。 エージェント専用のストアに置くと、可視化と同期を自前で用意することになる
- ステートは会話の外に置く。 ステータスとコメントを毎回読み直し、記憶で判断させない
- エッジは順方向だけ張る。 差し戻しのループを依存関係として張ると、着手できるノードを判定できなくなる
- レビューをノードにする。 それにより「どこで詰まっているか」がボード上に表現される
- ループには必ず上限と、深刻度による範囲の絞り込みを設計する。 「いつか終わる」はグラフの形からは保証されない
- 確認できていないものを合格にしない。 入力が届いていないなら、それらしい判定を返さず「審査できません」と返させる
- 入口を精緻化する。 完了条件が曖昧なままノードを構成すると、ノードの分だけやり直しが発生する
- 出口を整える。 AI の生産量は人間の読む速度をはるかに超える。成果物は人間が読み切れる形のドキュメントにまとめ、通知は要約とリンクだけにする
エージェントは疲れず、飽きず、手を抜きません。だからこそ、どこで止まるべきかは人間が設計する必要があります。グラフとして設計してみることで、AI と人間それぞれの得手不得手について、改めて理解が深まったように思います。
